Automação & Engenharia de Dados
Pipeline de Dados Automatizada para Campanhas de Mailing
ETL automatizado reduzindo tempo de execução em 57% e aumentando eficiência em 27%
Fotos Bônus / Detalhes
O Problema
As campanhas de mailing exigiam que, a cada hora das 08:00 às 20:00 (segunda a sábado), alguém executasse queries no PostgreSQL, aguardasse a finalização, exportasse resultados em CSV e importasse os arquivos no discador via SFTP. Esse processo apresentava alto risco de erro humano, atrasos nas campanhas e dependência total de operadores técnicos. O projeto surgiu durante minha transição de área, exigindo uma solução que eliminasse completamente a execução humana.
A Solução
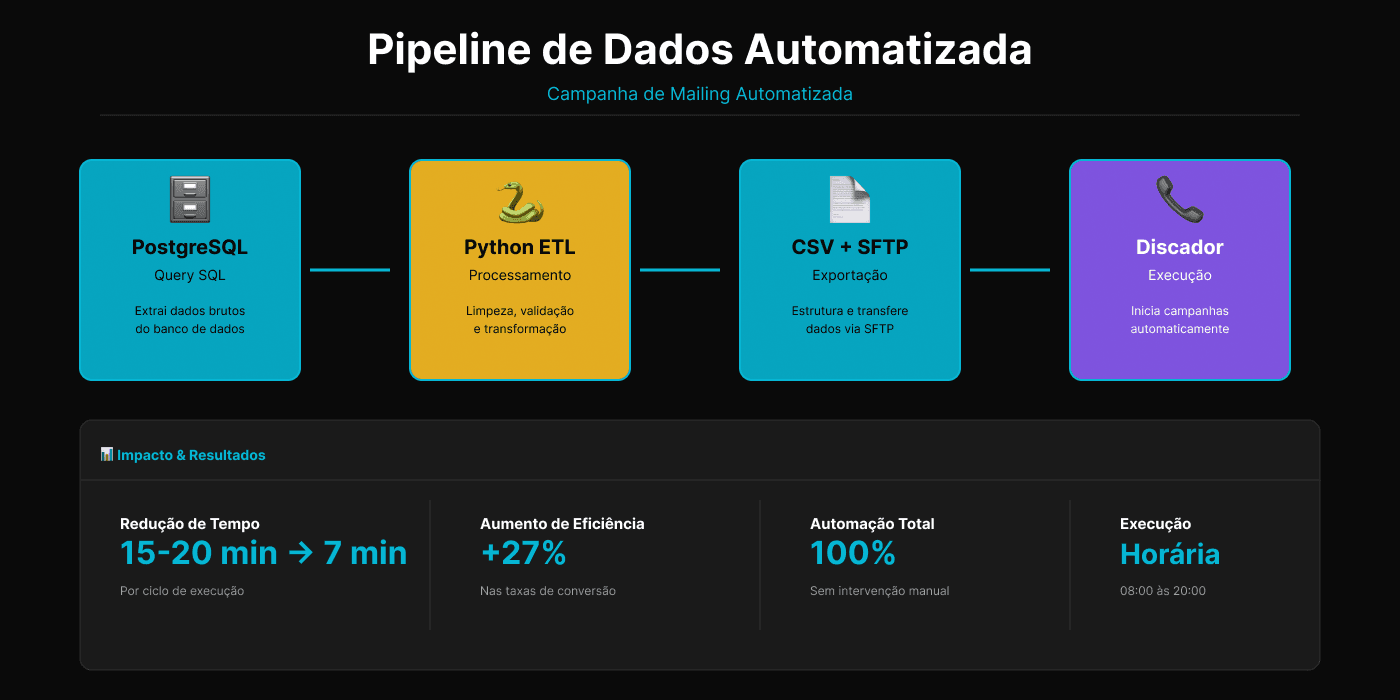
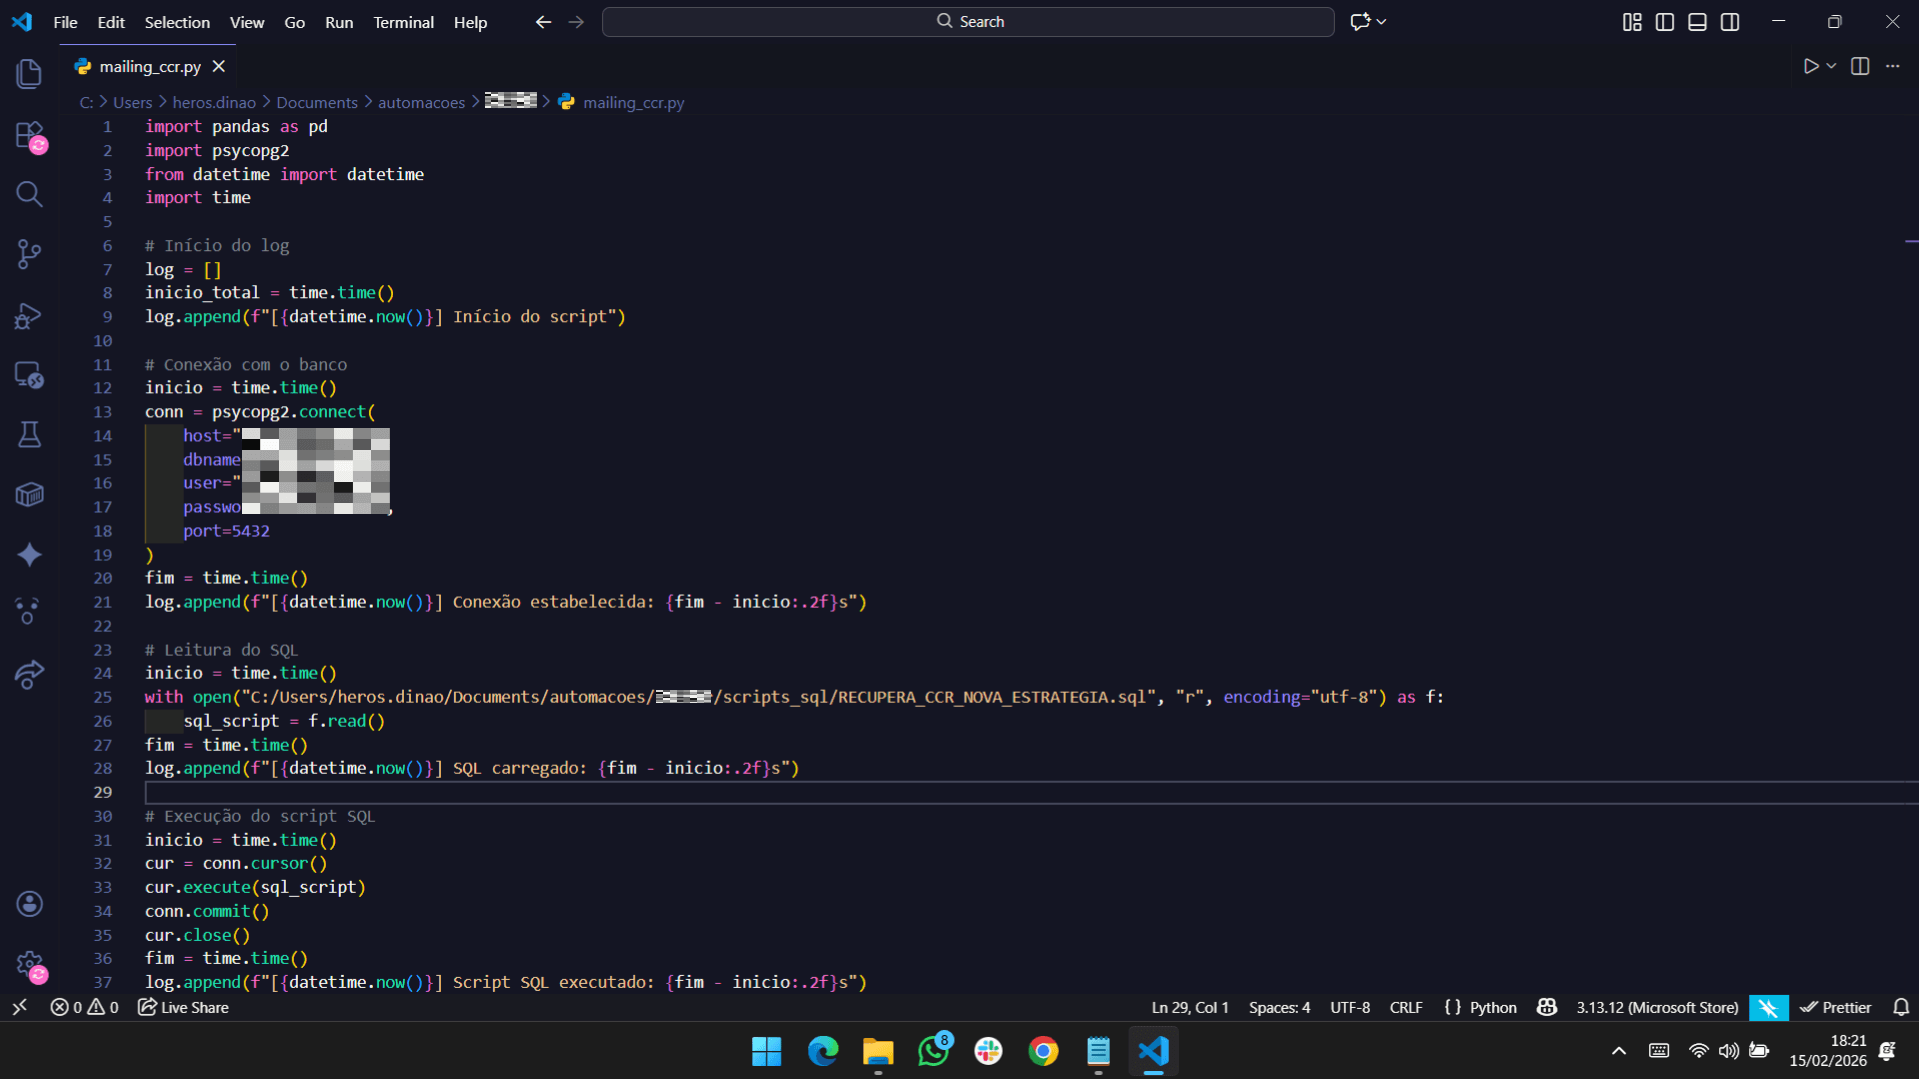
Desenvolvi uma pipeline de dados automatizada que executa de hora em hora: executa queries SQL no PostgreSQL, exporta resultados em CSV, nomeia arquivos dinamicamente com data/hora, envia automaticamente via SFTP para pastas mapeadas e o discador inicia a campanha automaticamente ao detectar o arquivo. O processo roda completamente headless, sem intervenção humana.
Stack Técnica
Impacto Gerado
- Redução do tempo de execução de 15-20 min → ~7 min por ciclo (57% mais rápido)
- Eliminação total do trabalho manual recorrente
- Menor quantidade de campanhas paradas
- Menor ociosidade das IAs de robocall
- Aumento de até 27% na eficiência das campanhas
- Melhora direta nas taxas de conversão e acordos/base
Redução de Tempo
15-20 min → ~7 min por ciclo
Eficiência
Aumento de até 27%
Execuções
Horária, automatizada
Stack Técnica
Visão Geral
Automação,
Engenharia de Dados
Stack Técnico
Desafios Técnicos
- Aprendizado e implementação de integrações Python com PostgreSQL e SFTP
- Contorno de limitações internas (GPO)
- Garantir estabilidade e tolerância a falhas de conexão
- Criar solução robusta sem infraestrutura dedicada (rodando em máquina local)